Content: cómo autoalojar transcripciones, resúmenes y documentos desde URLs y archivos
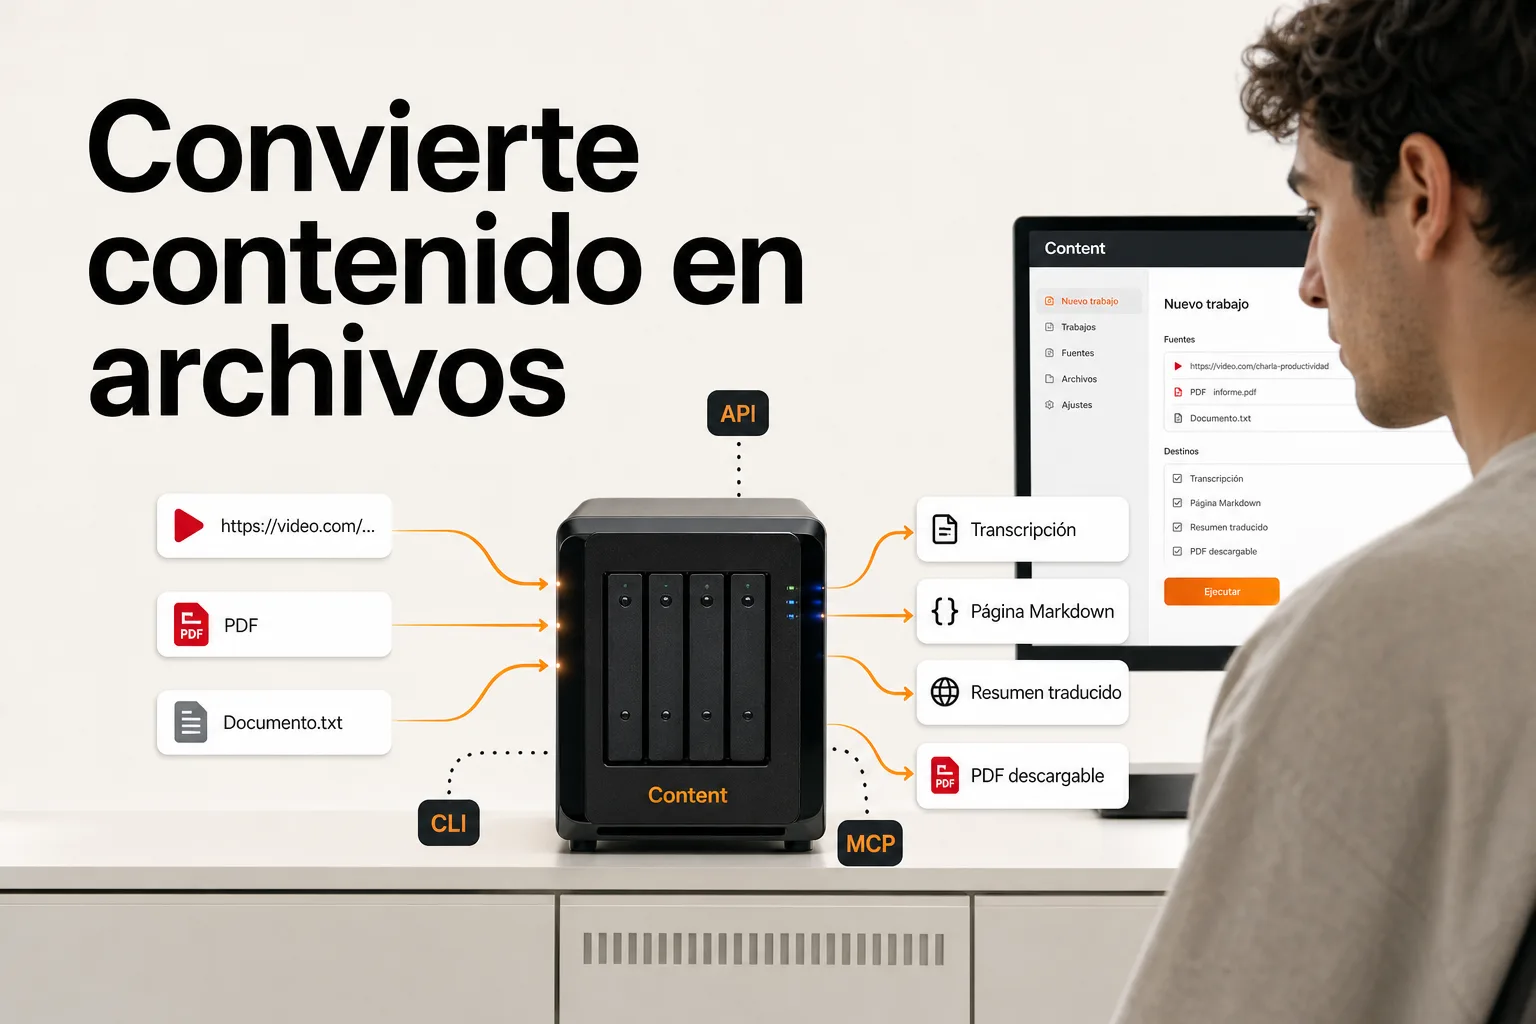
Una clínica, una academia o una asesoría suelen tener la información necesaria para publicar más: manuales internos, vídeos formativos, preguntas frecuentes, grabaciones, documentos PDF y textos que se reutilizan una y otra vez. El problema no suele ser la falta de contenido, sino el trabajo de convertirlo en formatos útiles.
Content es un motor autoalojado que intenta resolver esa capa de transformación. A partir de una URL, un archivo o un texto, puede generar transcripciones, resúmenes, traducciones, capítulos, Markdown, PDF, metadatos y otros artefactos. El proyecto se distribuye como un repositorio de código abierto de LatentNoise y reúne interfaz web, API REST, SDK de Python, CLI y servidor MCP alrededor del mismo contrato.
Qué hace Content y por qué importa su arquitectura
La diferencia principal frente a una colección de scripts independientes está en el flujo de trabajo. Content no obliga a decidir de antemano si debe ejecutarse yt-dlp, FFmpeg, Whisper, un modelo de lenguaje o un conversor PDF. Primero analiza la fuente, determina qué capacidades están disponibles, prepara un plan de ejecución y después genera los resultados como un trabajo observable.
El esquema es sencillo: fuentes, análisis, capacidades, plan, trabajo y artefactos. Así, una misma URL puede producir un vídeo, un audio, subtítulos, una transcripción, un resumen y un PDF. Del mismo modo, una página web o un archivo Markdown pueden convertirse en texto limpio, un resumen, una traducción o un documento descargable.
Esta separación también evita que cada interfaz tenga su propia lógica. Content Studio, HomeTube, la extensión para Chromium, el cliente MCP, la línea de comandos y el SDK de Python actúan como clientes del mismo backend. La arquitectura documentada del proyecto sitúa el contrato REST como punto común.
Un caso práctico para una pequeña empresa
Imaginemos una academia con un curso grabado sobre prevención de riesgos. El equipo puede introducir la URL de un vídeo o subir un archivo local y solicitar varios resultados: una transcripción completa, un resumen para el equipo docente, una traducción al inglés, un documento Markdown para editar y un PDF para entregar a los alumnos.
Una clínica podría aplicar un flujo parecido a sus preguntas frecuentes y protocolos internos. El material original no se convierte automáticamente en una página pública lista para publicar, pero sí puede alimentar un borrador revisable para la web, una ficha de servicio o un documento descargable.
En una asesoría, los manuales internos y las grabaciones de sesiones formativas podrían transformarse en documentación estructurada. La ventaja no está únicamente en generar texto, sino en conservar los artefactos en una biblioteca de archivos, con nombres legibles, rutas de entrega y trazabilidad del trabajo.
La decisión importante es que el resultado no queda encerrado en una conversación. Content produce archivos que pueden editarse, archivarse, incorporarse a una web o pasar a otro sistema.
Interfaz web, API, CLI, Python y MCP
La interfaz general es Content Studio, pensada para trabajar con URLs, archivos subidos, rutas disponibles en el servidor y texto introducido directamente. También existe HomeTube, una interfaz especializada en vídeos y listas de YouTube. El proyecto indica que Studio está disponible en el puerto 8502 y HomeTube en el 8501 cuando se utiliza la configuración Docker Compose incluida.
Para automatizar tareas, la CLI oficial permite analizar fuentes, enviar trabajos, consultar su estado y descargar artefactos. Es una opción razonable para procesos programados: por ejemplo, revisar periódicamente una carpeta de vídeos o lanzar una transformación desde un sistema de copias.
El SDK de Python ofrece clientes síncronos y asíncronos, además de modelos tipados. La API REST, documentada mediante OpenAPI, permite construir integraciones desde otros lenguajes.
El servidor MCP añade otra posibilidad: conectar Content con un agente compatible para pedirle que analice una fuente, solicite determinados resultados, supervise el trabajo y localice los archivos generados. Según la documentación del proyecto, el agente trabaja con acciones de intención —analizar, generar, consultar y obtener artefactos— sin tener que conocer comandos de terminal ni detalles internos del backend.
Qué necesita para resumir, traducir o transcribir
Content no incluye una dependencia obligatoria de servicios en la nube. Sin embargo, las funciones de inteligencia artificial requieren corredores o servicios compatibles. Los resúmenes, las traducciones y los capítulos derivados pueden conectarse a una instalación local de Ollama o a claves configuradas para proveedores externos. La transcripción desde audio necesita subtítulos existentes o un corredor de voz opcional basado en una API de audio compatible.
El sistema intenta mostrar la disponibilidad antes de iniciar un trabajo. Si una fuente no tiene subtítulos y no está instalado el corredor de voz, la transcripción no debería presentarse como disponible. Este comportamiento es especialmente útil en pequeñas organizaciones, donde conviene saber qué se puede generar antes de subir materiales o iniciar procesos largos.
Autoalojado no significa listo para exponer en Internet
El proyecto puede ejecutarse con Docker Compose en un equipo Linux o macOS, un NAS o un entorno doméstico. La instalación básica utiliza SQLite y almacenamiento local, sin exigir Redis, Celery, Kubernetes ni infraestructura cloud.
Hay, no obstante, una advertencia que no conviene pasar por alto: la API V1 no incorpora autenticación. La propia documentación de seguridad señala que cualquiera que alcance la API podría enviar trabajos, subir archivos y leer los artefactos. Por eso, una instalación real debe mantenerse en una red de confianza o situarse detrás de un proxy inverso con autenticación. No es una herramienta para publicar directamente el puerto en Internet.
También hay límites funcionales. La documentación actual indica que no ofrece OCR para documentos escaneados, no trabaja todavía con formatos como DOCX, EPUB, ODT o RTF, no hace transcodificación y no incorpora sincronización continua de listas de reproducción. La licencia es la Functional Source License 1.1 con futura transición a Apache 2.0, así que conviene revisarla antes de integrarlo en un producto comercial.
Una base para reutilizar contenido, no un publicador automático
Content resulta interesante porque concentra en un único motor tareas que normalmente obligan a unir descargadores, conversores, modelos de transcripción, servicios de traducción y scripts de entrega. Para una pequeña empresa, eso puede reducir el trabajo de construir una cadena interna desde cero.
Pero el resultado sigue necesitando revisión humana. Una transcripción puede contener errores; un resumen puede omitir matices; una traducción puede requerir adaptación sectorial; y un documento interno no debería convertirse en contenido público sin comprobar permisos, datos personales y precisión.
La propuesta más sensata es utilizar Content como una fábrica local de borradores y artefactos: centraliza las fuentes, automatiza las transformaciones repetitivas y deja la decisión editorial en manos del equipo. Ahí es donde el autoalojamiento aporta valor real: no en prometer que el contenido se publica solo, sino en mantener bajo control el proceso que lo convierte en algo reutilizable.